正文
Everywhere | 基于AI感知视觉桌面小助手
[前言]
Everywhere 是一款面向 Windows 和 macOS 的开源桌面 AI 助手,核心理念是让 AI 直接融入当前使用的软件,而不是每次都切换到浏览器、复制文字、粘贴内容再提问。它可以感知当前屏幕和应用上下文,并调用 AI 模型、浏览器、文件系统及终端工具来完成任务
[功能]
功能类别 | 主要功能 | 具体用途 |
|---|---|---|
屏幕上下文感知 | 读取当前应用、窗口和屏幕内容 | 不必反复截图、复制粘贴 |
快捷键唤起 | 使用全局快捷键打开 AI | 在浏览器、编辑器等软件中随时提问 |
划词交互 | 选中文字后让 AI 处理 | 翻译、解释、改写、总结 |
网页内容总结 | 提取页面关键信息 | 总结文章、提炼知识点 |
多模型支持 | 接入多家 AI 服务 | 按任务选择合适的模型 |
AI Agent 工具 | 调用浏览器、文件系统等工具 | 搜索资料、读取文件、执行任务 |
终端命令执行 | 通过 AI 辅助运行 Shell 命令 | 排查错误、管理服务、运行脚本 |
子代理 | 分派任务给子 Agent | 拆分复杂任务并处理不同子任务 |
MCP 工具 | 连接兼容的外部工具 | 扩展 AI 助手的操作能力 |
自定义助手与策略 | 配置模型、提示词及工具组合 | 针对不同场景设置工作流程 |
多会话与历史记录 | 管理对话和查看历史 | 区分不同任务、继续之前的工作 |
本地模型 | 支持通过 Ollama 使用模型 | 在本机运行兼容的本地大模型 |
多语言界面 | 支持简体中文等多种语言 | 使用中文界面与提示词 |
云服务 | 使用官方提供的 AI 服务 | 减少自行配置模型 API 的工作 |
[模型]
项目 | 支持情况 |
|---|---|
OpenAI | 支持 |
Anthropic Claude | 支持 |
Google Gemini | 支持 |
DeepSeek | 支持 |
Moonshot Kimi | 支持 |
MiniMax | 支持 |
Ollama 本地模型 | 支持 |
自定义兼容 API | 支持 |
Windows | 支持 |
macOS | 支持 |
Linux | 官方项目资料中列为开发中 |
[场景]
使用时要特别注意: 屏幕上下文感知可能涉及当前窗口中的敏感信息;终端脚本执行也可能修改文件、服务或系统配置。建议审查执行命令、谨慎授予自动批准权限,并避免向不可信的模型服务发送密码、令牌等机密信息。
用户类型 | 推荐程度 | 原因 |
|---|---|---|
Web 开发人员 | 很适合 | 代码分析、报错诊断、终端辅助 |
Linux 服务器管理员 | 适合 | 生成和辅助执行运维命令 |
日常办公用户 | 适合 | 阅读、总结、翻译、邮件润色 |
AI 自动化爱好者 | 很适合 | Agent、MCP、子代理及自定义策略 |
只需要普通 AI 聊天的用户 | 视需求而定 | 如果不需要屏幕感知和工具执行,普通聊天工具可能更简单 |
[预览]
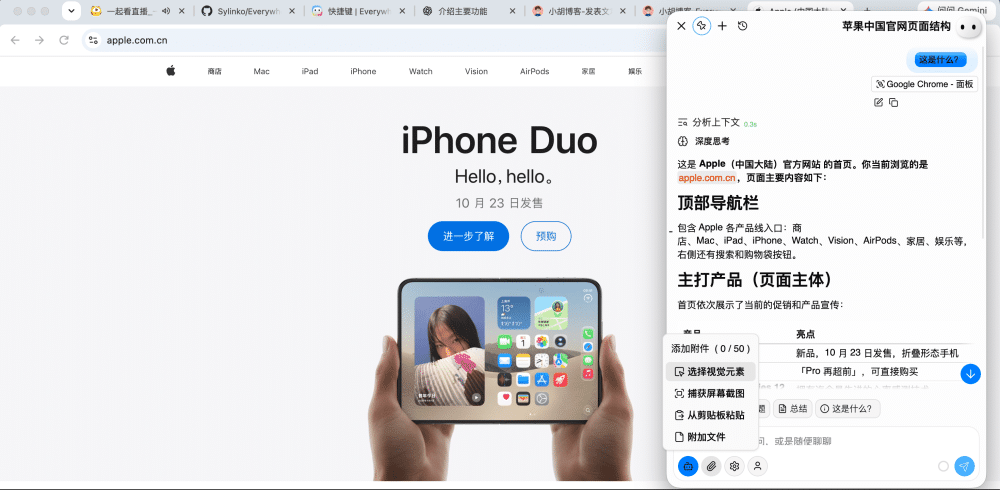
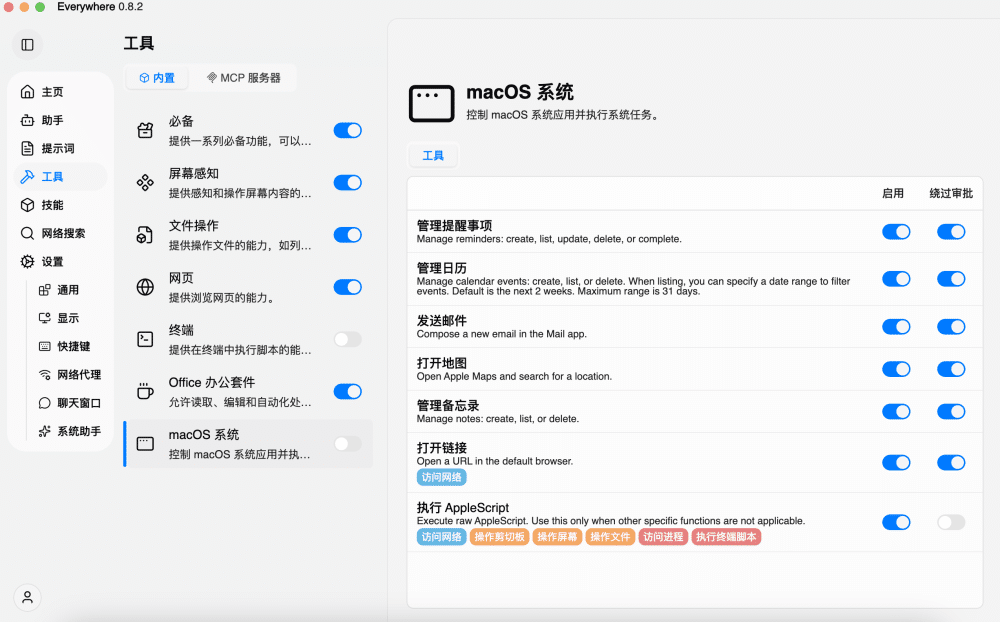
Everywhere 使用之前配置一下模型的标识和API密钥,macos需要打开辅助功能,算是基于ai视觉捕获当前的窗口,直接发给大模型的便携助手,当然还有其他功能,例如:文本、网页、服务器运维等等,可以自行尝试,注意隐私保护,也可以选择本地大模型
[下载]
相关